[C++/CS] 해시 충돌이 발생하는 key 값이 자신의 value를 찾아가는 방법 (unordered_map) + 체이닝의 캐시 효율
해시 충돌 발생 시 동일한 해시로 원하는 값을 찾아가는 과정과 unordered_map의 내부 동작 원리 분석 + 캐시 효율성에 대한 궁금증 해결
라이선스 표기
Copyright (c) Microsoft Corporation. SPDX-License-Identifier: Apache-2.0 WITH LLVM-exception 모든 코드는 표기된 라이센스를 따르며, 설명을 위해 수정된 사항이 있습니다
해시 충돌에 대한 글: https://en.wikipedia.org/wiki/Hash_table https://preamtree.tistory.com/20
해시 충돌이 발생하면 개방 주소법이나 체이닝을 통해 해결한다는 것은 익히 들어 알고 있을 것입니다. 그런데 문득 이런 생각이 들었습니다. 충돌이 발생한다는 것은 해시 함수가 return하는 해시 값이 동일하다는 것인데, 어떻게 프로그램이 원하는 값을 정확히 찾아올 수 있냐는 것입니다.
해시 값만 사용하는 것이 아님
해시 테이블은 해시 값 하나만 믿고 데이터를 찾지 않습니다. 충돌이 발생하면 ① 충돌을 해결하는 규칙(개방 주소법 또는 체이닝)에 따라 보관해 두고, 나중에 값을 찾을 때는 ② 주소를 따라간 뒤 “진짜 내가 찾던 키(Key)가 맞는지” 실제 키 값을 직접 비교하는 과정을 거칩니다.
구체적으로 두 방식이 충돌을 해결하고 원하는 값을 찾아가는 과정은 다음과 같습니다.
1. 개방 주소법 (Open Addressing)
개방 주소법에서는 해시 테이블의 각 칸에 데이터(Key, Value)가 직접 들어갑니다.
동작 방식
예를 들어 Key A와 Key B가 모두 해시 값 3을 출력했다고 가정해 보겠습니다.
- 저장할 때:
Key A가 먼저 들어와 index3에 저장됩니다.Key B가 들어왔는데 index3이 차 있습니다.- 약속된 규칙(예: 다음 칸으로 이동)에 따라 빈 칸인 index
4에Key B를 저장합니다.
- 찾아갈 때 (
Key B를 검색하는 과정):Key B를 해시 함수에 넣어 index3을 얻습니다.- index
3으로 가보니Key A가 들어있습니다. “해시 값은 맞지만, 진짜 키(Key B)가 아니네?” 하고 확인합니다. - 저장할 때 썼던 규칙 그대로 다음 칸(index 4)으로 이동합니다.
- index
4에서Key B를 발견하고, 키가 일치하므로 해당 값을 반환합니다.
2. 체이닝 (Chaining)
체이닝 방식에서 해시 테이블의 각 칸은 데이터 자체가 아니라, 연결 리스트의 첫 번째 노드를 가리키는 포인터를 가집니다.
동작 방식
마찬가지로 Key A와 Key B의 해시 값이 둘 다 3인 경우입니다.
- 저장할 때:
Key A가 들어와 index3번 방의 리스트에 첫 번째 노드로 들어갑니다. ([Key A]연결)Key B가 들어오면 index3번 방의 리스트 끝(또는 앞)에 추가로 연결합니다. ([Key A] -> [Key B]연결)
- 찾아갈 때 (
Key B를 검색하는 과정):Key B를 해시 함수에 넣어 index3을 얻습니다.- index
3번 방으로 찾아가 연결된 리스트를 첫 번째 노드부터 순회합니다. - 첫 노드
Key A확인 $\rightarrow$ “내가 찾던 키가 아님” - 다음 노드
Key B확인 $\rightarrow$ “진짜 키가 맞음!” $\rightarrow$ 검색 성공
결국, 해시 충돌이 발생하더라도 원하는 값을 정확히 찾을 수 있는 이유는 “해시 값(주소)”뿐만 아니라 “원래의 Key 값”도 함께 저장하여 최종 비교하기 때문입니다. 단순하면서도 당연한 방법이었습니다. 그럼 자주 사용해왔던 unordered_map은 내부적으로 어떻게 동작할까요? 또한, 체이닝을 사용하는지 개방 주소법을 사용하는지도 알아봤습니다.
C++ std::unordered_map
unordered_map은 체이닝(Chaining) 방식을 사용합니다. 각 버킷이 단방향 연결 리스트(Singly Linked List) 형태의 노드들을 가리키는 구조로 구현되어 있습니다. **여기서 중요한 것은 해시 충돌 여부와 상관없이 데이터가 들어오면 무조건 리스트 노트가 동적 할당되어 생성된다는 것입니다. **
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
template <class _Keyty, class _Mappedty>
    pair<iterator, bool> _Insert_or_assign(_Keyty&& _Keyval_arg, _Mappedty&& _Mapval) {
        const auto& _Keyval   = _Keyval_arg;

        // [해시 값 계산]
        // 입력받은 키(_Keyval)를 해시 함수에 넣어 해시 숫자(_Hashval)를 얻어냅니다.
        const size_t _Hashval = this->_Traitsobj(_Keyval);

        // [기존 키 존재 여부 확인 및 리스트 순회]
        // _Find_last 함수를 통해 해당 해시값의 버킷으로 찾아가 연결 리스트를 뒤져서
        // 이미 똑같은 키(_Keyval)가 존재하는지 검사합니다.
        auto _Target          = this->_Find_last(_Keyval, _Hashval);

        // 만약 이미 일치하는 키가 존재한다면 (해시 충돌이 아니라 아예 동일한 키인 경우)
        if (_Target._Duplicate) {
            // 새 노드를 만들지 않고, 기존 노드의 Value(second) 값만 새로 덮어씌우고 종료합니다.
            _Target._Duplicate->_Myval.second = _STD forward<_Mappedty>(_Mapval);
            return {this->_List._Make_iter(_Target._Duplicate), false};
        }

        // 최대 사이즈(load factor 등)를 초과했는지 체크합니다.
        this->_Check_max_size();

        // [새로운 노드 생성 (해시 충돌 여부와 상관없이 무조건 생성)]
        // invalidates _Keyval:
        // _List_node_emplace_op2라는 객체를 통해 새로운 리스트 '노드(Node)'를 동적 할당하여 생성합니다.
        // 이 노드 안에는 키(_Keyval_arg)와 값(_Mapval)이 담기게 됩니다.
        _List_node_emplace_op2<_Alnode> _Newnode(
            this->_Getal(), _STD forward<_Keyty>(_Keyval_arg), _STD forward<_Mappedty>(_Mapval));

        // 만약 요소를 추가하기 전에 해시 테이블의 크기(버킷 수)를 늘려야 한다면 재해싱(Rehash)을 수행합니다.
        if (this->_Check_rehash_required_1()) {
            this->_Rehash_for_1();
            // 버킷 개수가 바뀌었으므로, 새로 만든 노드가 들어갈 위치를 다시 찾습니다.
            _Target = this->_Find_last(_Newnode._Ptr->_Myval.first, _Hashval);
        }

        // [체이닝 (리스트에 노드 연결)]
        // _Insert_new_node_before 함수를 호출하여, 방금 생성한 새 노드(_Newnode._Release())를
        // 해당 해시값(_Hashval) 버킷이 가리키는 연결 리스트의 특정 위치(_Target._Insert_before)에
        // 체이닝(연결) 한 뒤 iterator를 반환합니다.
        return {this->_List._Make_iter(
                    this->_Insert_new_node_before(_Hashval, _Target._Insert_before, _Newnode._Release())),
            true};
    }
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
_NODISCARD mapped_type& at(const key_type& _Keyval) {
        // [해시 계산 및 타겟 탐색]
        // _Traitsobj(_Keyval)을 통해 해시값을 먼저 구합니다.
        // 그리고 부모 클래스(_Hash)의 _Find_last 함수에 '찾고자 하는 원본 키(_Keyval)'와 '해시값'을 같이 넘깁니다.
        // _Find_last 내부에서는 해시값으로 해당 버킷을 찾은 뒤, 버킷에 연결된 단방향 연결 리스트를 순회하며
        // 리스트 내 각 노드의 키와 전달한 '_Keyval'이 정확히 일치(key_equal)하는지 하나씩 비교합니다.
        const auto _Target = this->_Find_last(_Keyval, this->_Traitsobj(_Keyval));

        // [실제 키 일치 확인]
        // 해시값이 같고, 실제 키 값까지 정확히 일치하는 진짜 노드를 찾았다면
        // _Target._Duplicate에 그 노드의 포인터가 담겨서 돌아옵니다.
        if (_Target._Duplicate) {
            // 찾은 노드의 실제 Value(_Myval.second)를 반환합니다.
            return _Target._Duplicate->_Myval.second;
        }

        // [탐색 실패]
        // 해시값이 같은 버킷으로 갔지만, 연결 리스트를 다 뒤져봐도
        // 실제 키 값이 일치하는 노드가 없다면 예외(out_of_range)를 던집니다.
        _Xout_of_range("invalid unordered_map<K, T> key");
    }
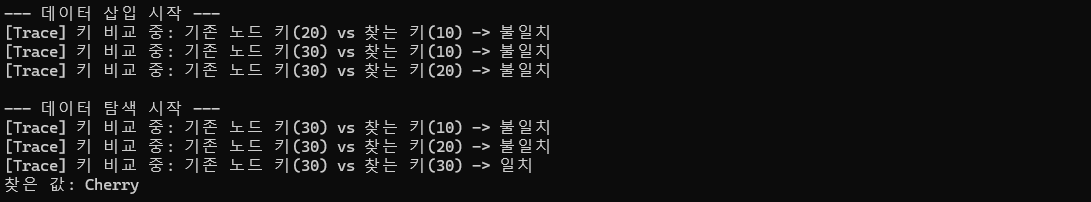
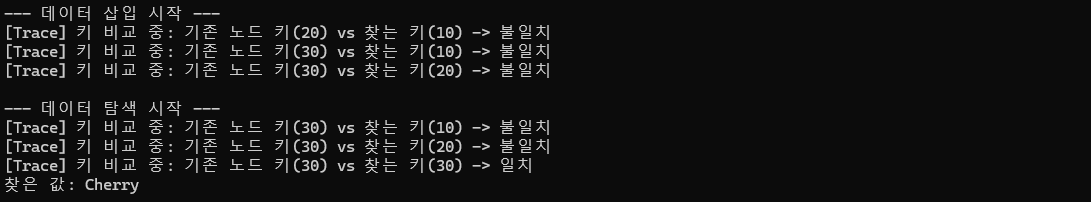
체이닝 과정을 확인하기 위해 디버깅 모드와 아래 소스코드를 활용했습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39

#include <iostream>
#include <unordered_map>
#include <string>

// 1. 해시 충돌을 발생시키는 커스텀 해시 함수
struct CollisionHash {
    size_t operator()(const int& key) const {
        return 1; // 어떤 키가 들어와도 무조건 해시값 1을 반환! (같은 방 배정)
    }
};

// 2. 키 비교 과정을 관찰하기 위한 커스텀 동등성 비교 함수
struct TraceEqual {
    bool operator()(const int& lhs, const int& rhs) const {
        // 🔴 [디버깅 정지 지점 1]
        bool result = (lhs == rhs);
        std::cout << "[Trace] 키 비교 중: 기존 노드 키(" << lhs << ") vs 찾는 키(" << rhs << ") -> " << (result ? "일치" : "불일치") << "\n";
        return result;
    }
};

int main() {
    std::unordered_map<int, std::string, CollisionHash, TraceEqual> my_map;

    std::cout << "--- 데이터 삽입 시작 ---\n";
    my_map[10] = "Apple";  // 버킷 1에 삽입 (길이 1)

    // 🔴 [디버깅 정지 지점 2] 삽입 시 순회 확인을 원한다면 여기서 Step Into(F11)를 해보세요
    my_map[20] = "Banana"; // 해시가 1이므로 충돌! 리스트를 뒤지며 10과 20을 비교함
    my_map[30] = "Cherry"; // 해시가 1이므로 충돌! 리스트를 뒤지며 10, 20과 30을 순차적으로 비교함

    std::cout << "\n--- 데이터 탐색 시작 ---\n";
    // 🔴 [디버깅 정지 지점 3] 탐색 시 순회 확인을 원한다면 여기서 Step Into(F11)를 해보세요
    std::string value = my_map.at(30);
    std::cout << "찾은 값: " << value << "\n";

    return 0;
}
unordred_map은 체이닝을 사용하기 때문에 많은 데이터가 들어왔을 때, 다른 컨테이너에 비해 성능이 그다지 좋지 않습니다(캐시 효율성 문제). 그런데도 왜 체이닝을 사용했는지 이유가 궁금했습니다. 제 궁금증에 대한 답변은 아래 링크에서 얻을 수 있었습니다.
https://www.reddit.com/r/cpp/comments/sprdom/why_does_unordered_map_use_chaining_to_prevent/
번역하자면 다음과 같습니다.
- 빈 자리와 이미 차 있는 자리를 구분할 필요가 있습니다.
- 해시 테이블을 기본 생성자(default constructor)가 있는 타입으로만 제한하여 모든 배열 요소를 미리 생성해 두거나, 아니면 일부 요소는 객체이고 나머지는 가공되지 않은 순수 메모리(raw memory)로 이루어진 배열을 유지해야 합니다.
- 개방 주소법(Open addressing)은 충돌 관리를 어렵게 만듭니다. 해시 코드가 이미 차 있는 위치에 매핑되는 요소를 삽입하려는 경우, 다음으로 어디를 시도해야 할지 알려주는 정책이 필요합니다. 이는 이미 해결된 문제이지만, 가장 잘 알려진 솔루션들도 복잡합니다.
- 충돌 관리는 요소를 삭제(erase)할 수 있을 때 특히 더 복잡해집니다. (이와 관련해서는 크누스(Knuth) 교수의 논의를 참조하세요.) 표준 라이브러리용 컨테이너 클래스는 당연히 삭제를 허용해야 합니다.
- 개방 주소법을 위한 충돌 관리 방식들은 대체로 최대 N개의 요소를 담을 수 있는 고정 크기 배열을 전제로 하는 경향이 있습니다. 표준 라이브러리용 컨테이너 클래스는 사용 가능한 메모리 한도 내에서 새 요소가 삽입될 때마다 필요한 만큼 크기가 늘어날 수 있어야 합니다.
현대에는 Swiss Map같은 방식을 이용해서 캐시 효율 문제를 해결했다고 합니다.